El 30 de octubre, Kevin Kelley, de Anthropic, presentó en el IETF una regla común para el robots.txt. El IETF es el organismo donde se discuten las normas técnicas de internet. La regla sirve para que una web pida que su contenido no se use para entrenar inteligencia artificial generativa. Ese mismo día Google y Microsoft anunciaron que piensan respetarla, y OpenAI también, según The Next Web. Hasta ahora había que escribir una regla para cada empresa, con el nombre de su rastreador, que es el programa que recorre las webs. Ninguna de las cuatro ha dicho que ya la esté respetando.
Cómo es la regla
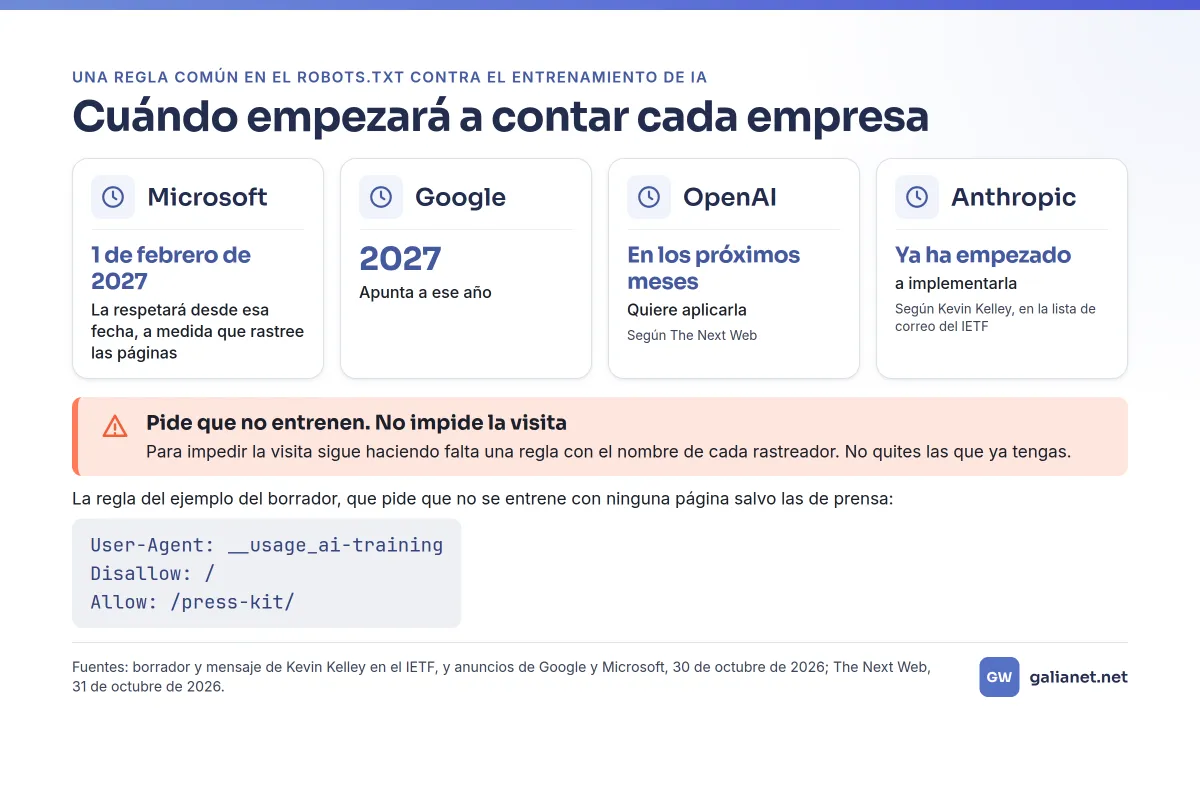
El robots.txt es el archivo de texto donde una web pide a los programas automáticos que no entren en ciertas páginas. La regla nueva no nombra a un rastreador, sino un uso: __usage_ai-training. Debajo van las rutas, con la misma forma de siempre. El ejemplo del borrador pide que no se entrene con ninguna página salvo las de la carpeta de prensa:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
El borrador fija tres detalles:
- Si el archivo no lleva ese grupo, la web no ha expresado ninguna preferencia.
- La regla general para todos los robots, User-Agent: *, no cuenta como una preferencia sobre el entrenamiento.
- Un acuerdo privado entre la web y una empresa de IA puede pasar por encima de lo que diga el archivo.
Lo que entiende por entrenar sale del grupo de trabajo del IETF: usar el contenido para modificar lo que ha aprendido un modelo de IA generativa. Los modelos que se usan solo para clasificar, ordenar o puntuar quedan fuera.
Lo que la regla no hace
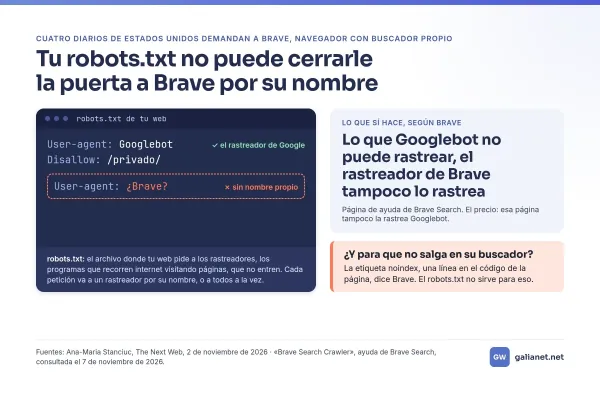
Expresa una preferencia sobre el uso del contenido. Según el propio borrador, no es una orden sobre si el robot puede visitar la página. Para impedir la visita sigue haciendo falta una regla con el nombre de cada rastreador.
Como todo el robots.txt, es una petición, y la respeta quien se ha comprometido a respetarla. Microsoft aclara además que sus preferencias no establecen acuerdos de licencia ni de pago.
Y es un borrador de trabajo. Según The Next Web, es una propuesta individual que el IETF no ha respaldado. Un borrador así caduca si no se renueva, y la portada de este pone el 3 de mayo de 2027.
Cuándo empieza a contar cada empresa
- Microsoft la respetará desde el 1 de febrero de 2027, a medida que rastree las páginas. Y dice que estas preferencias no cambian que una página pueda salir en los resultados normales de Bing.
- Google apunta a 2027. Su control propio para el entrenamiento se llama Google-Extended. Si una web dice que no con la regla común y no menciona Google-Extended, Google piensa leerlo como si lo hubiera bloqueado.
- OpenAI, según The Next Web, quiere aplicarla en los próximos meses, y sus controles actuales, como el bloqueo de GPTBot, siguen valiendo.
- Anthropic ya ha empezado a implementarla, según escribió Kelley en la lista de correo del IETF. Añadió que complementa sus controles actuales y que llevará tiempo llegar a todos sus servicios.
Meta no está entre las cuatro. Según The Next Web, que lo toma de The Verge, su jefe de comunicación apoyó en X una señal común, pero no dijo si Meta la respetará. Es la misma empresa cuyas nuevas condiciones le permitirán rastrear la web de quien gestiona una página de Facebook, como contamos el 27 de octubre.
Lo que puede costar decir que no
Según su anuncio, Google piensa leer la regla común como un bloqueo de Google-Extended cuando la web no lo nombre. Y el mismo anuncio dice que las webs que permiten expresamente Google-Extended pueden aparecer en las respuestas de la aplicación Gemini y recibir clics desde ellas. También dice que la regla común convive con los controles de cada empresa, así que Google-Extended se puede seguir nombrando aparte.
Microsoft separa las dos cosas. Decir que no al entrenamiento no cambia si tu contenido alimenta sus respuestas con IA. Para eso añade otra preferencia, página a página, y avisa de que bloquear ese uso reduce mucho la visibilidad en esas respuestas.
Qué puedes hacer ahora
- Mira qué dice hoy el robots.txt de tu web. Se ve abriendo su dirección seguida de /robots.txt.
- Decide si quieres decir que no al entrenamiento. La regla se puede escribir ya: según el borrador, los programas que no la conocen la ignoran, como hacen con cualquier nombre de robot que no reconocen. Contará cuando cada empresa empiece a leerla.
- No quites las reglas por nombre que ya tengas. La regla común no impide la visita. Google, Anthropic y, según The Next Web, OpenAI dicen que sus controles propios siguen valiendo.
- Si te importa aparecer en Gemini, piensa en Google-Extended antes de escribir la regla común. Según el anuncio de Google, se puede nombrar aparte con su propia regla.
Nuestro gestor de contenidos deja editar el robots.txt desde su sección Varios. Si estás pensando en una web nueva, cuéntanos qué necesitas y te preparamos una propuesta hecha para ti.
Fuentes
- Kevin Kelley (Anthropic), «Machine-Readable Training Preference Signal», borrador draft-kelley-aipref-training-preference-signal-00, IETF, 30 de octubre de 2026: https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
- John Mueller, «Supporting a shared AI training control for websites», Google Search Central Blog, 30 de octubre de 2026: https://developers.google.com/search/blog/2026/10/ai-training-control
- Krishna Madhavan, «Your content, your choice: clearer preferences for training and grounding», Bing Blog, 30 de octubre de 2026: https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
- Kevin Kelley, «New draft: draft-kelley-aipref-training-preference-signal-00», lista de correo ai-control del IETF, 30 de octubre de 2026: https://mailarchive.ietf.org/arch/msg/ai-control/mddjatOxSR0h6GmLRBWlc839c7w/
- Ana Maria Constantin, «Google, Microsoft, OpenAI and Anthropic back one AI training opt-out», The Next Web, 31 de octubre de 2026: https://thenextweb.com/news/ai-training-opt-out-robots-txt-google-openai-microsoft-anthropic
- Natalia Polo, «Google, Microsoft, OpenAI y Anthropic aceptarán una sola línea en robots.txt para decir “no entrenes con mi web”», WWWhat's new, 1 de noviembre de 2026: https://wwwhatsnew.com/2026/11/01/robots-txt-senal-comun-entrenamiento-ia-google-microsoft-openai-anthropic/