Si tu negocio tiene una página de Facebook, Meta va a cambiar el contrato que aceptas al gestionarla. Las nuevas Condiciones comerciales incluyen un permiso para que sus programas visiten y guarden las páginas web asociadas con tus productos o servicios. Meta ha retrasado la entrada en vigor. Según Search Engine Journal, que lo toma de Nieman Lab, a 23 de octubre las condiciones no habían cambiado en nada más que la fecha.
Qué contrato es y desde cuándo
Las Condiciones comerciales de Meta se aplican al uso de sus productos con fines comerciales o empresariales, salvo que Meta diga que rigen otras. La propia lista de Meta incluye anunciarse, vender, crear un catálogo de productos y la administración de una página.
La fecha tiene un detalle. En la versión para España, consultada el 27 de octubre, el aviso de arriba dice que los cambios entrarán en vigor el 20 de noviembre de 2026. La última línea de la misma página dice todavía 30 de octubre de 2026. Search Engine Journal contó el 26 de octubre que Meta había retrasado la fecha del 30 de octubre al 20 de noviembre. Según el mismo medio, en algunas versiones locales seguía apareciendo la antigua.
El apartado 7 explica cómo se aceptan. Si sigues usando los productos de Meta para tu empresa después de recibir el aviso, quedas sujeto a las condiciones actualizadas. Si no estás de acuerdo, la salida que ofrece es dejar de usarlos.
Qué permite el párrafo
Está en el apartado 1, «Licencias y derechos que otorgas a Meta». Autoriza a Meta, y a quien actúe en su nombre, a usar software automatizado y a crear credenciales de prueba, es decir, accesos de prueba. Con ellos puede entrar en los dominios y páginas web asociados con tus productos o servicios, o a los que se llega a través de sus productos. Y le deja catalogarlos, guardar copias, analizarlos y obtener actualizaciones de ellos de forma periódica.
La finalidad que declara es amplia. Habla de proporcionar, desarrollar, mejorar, investigar y mantener productos publicitarios y empresariales, y de mantener la integridad y la seguridad de sus productos.
En el texto en español no aparece el archivo robots.txt. Según Search Engine Journal, tampoco en la versión en inglés de Estados Unidos.
Lo que hace el robots.txt, y lo que no dice el contrato
El robots.txt es un archivo de texto donde una web pide a los programas automáticos que no entren en ciertas páginas. Es una petición, no un candado: lo respeta quien quiere respetarlo.
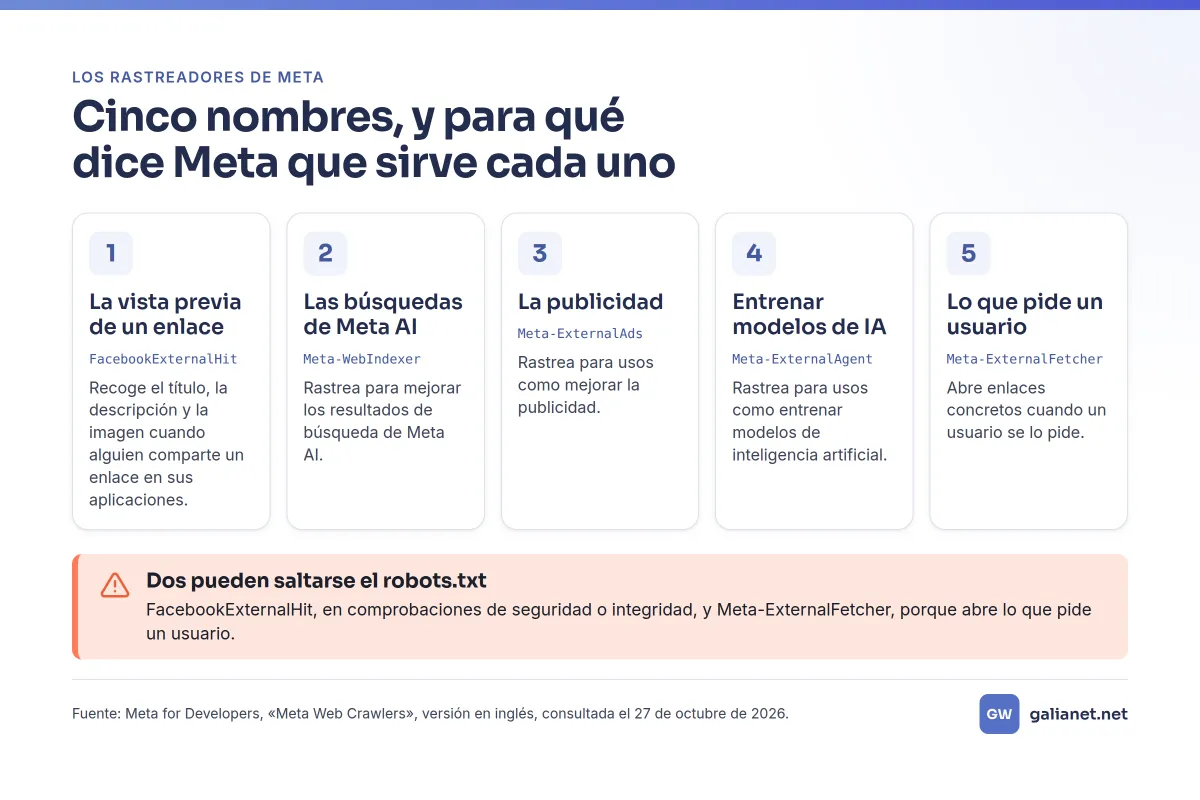
Meta publica una página con sus rastreadores. Para bloquearlos, dice, hay que añadir en ese archivo una regla que nombre al rastreador concreto. La página nombra cinco, y cada uno tiene su función:
- FacebookExternalHit recoge el título, la descripción y la imagen de una web cuando alguien comparte un enlace suyo en las aplicaciones de Meta, como Facebook.
- Meta-WebIndexer rastrea para mejorar los resultados de búsqueda de Meta AI.
- Meta-ExternalAds rastrea para usos como mejorar la publicidad.
- Meta-ExternalAgent rastrea para usos como entrenar modelos de inteligencia artificial.
- Meta-ExternalFetcher abre enlaces concretos cuando un usuario se lo pide.
La misma página avisa de dos excepciones. FacebookExternalHit puede saltarse el robots.txt en comprobaciones de seguridad o integridad, y Meta-ExternalFetcher también, porque abre lo que pide un usuario. Y un cambio en el archivo puede tardar hasta 24 horas en notarse.
Queda una pregunta sin respuesta. Según Search Engine Journal, Meta dice que el robots.txt sirve para influir en cómo rastrea, pero las nuevas condiciones no aclaran si ese archivo limita el permiso que concedes al aceptarlas.
Qué puedes hacer antes del 20 de noviembre
- Lee el párrafo entero en la versión española de las condiciones, enlazada abajo. Es el segundo párrafo del apartado 1.
- Mira qué dice hoy el robots.txt de tu web sobre cada uno de esos cinco nombres. Basta con abrir la dirección de tu web seguida de /robots.txt.
- Decide rastreador a rastreador, no a Meta entera. Antes de cerrar la puerta a uno, mira para qué sirve: el que prepara la vista previa de tus enlaces compartidos es FacebookExternalHit.
- Ten en cuenta que puede cambiar. Según Search Engine Journal, una asociación de anunciantes y editores ha pedido a la Comisión Europea y a la autoridad de competencia británica que frenen estas condiciones. Meta le dijo a Reuters que no está de acuerdo con la queja.
Nuestro gestor de contenidos deja editar el robots.txt desde su sección Varios. Si estás pensando en una web nueva, cuéntanos qué necesitas y te preparamos una propuesta hecha para ti.
Fuentes
- Meta, «Condiciones comerciales de Meta», versión actualizada en español de España, con aviso de entrada en vigor el 20 de noviembre de 2026, consultada el 27 de octubre de 2026: https://www.facebook.com/legal/commercial_terms_preview?locale=es_ES
- Meta for Developers, «Meta Web Crawlers», versión en inglés, consultada el 27 de octubre de 2026: https://developers.facebook.com/documentation/sharing/webmasters/web-crawlers
- Matt G. Southern, «Meta Delays The Terms That Let It Crawl Business Sites», Search Engine Journal, 26 de octubre de 2026: https://www.searchenginejournal.com/meta-delays-business-terms-crawling/594388/