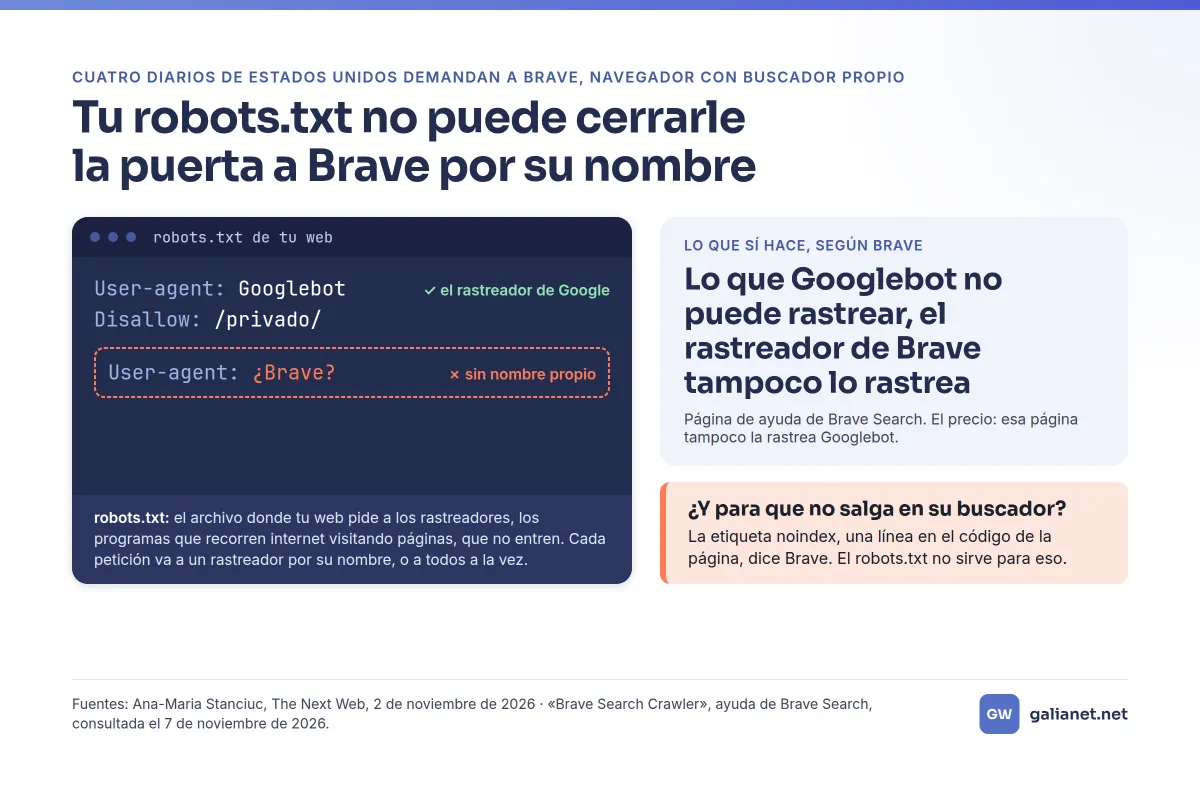
Tu web puede tener un archivo llamado robots.txt. Es una lista de peticiones para los rastreadores, los programas que recorren internet visitando páginas: «aquí no entres». Cada rastreador se presenta con un nombre cuando visita una página, y el robots.txt usa ese nombre para dirigirle una petición a él, o a todos a la vez. El de Google, por ejemplo, se llama Googlebot.
Brave es un navegador, como Chrome o Firefox, y tiene también un buscador propio con su rastreador. Pero ese rastreador no se presenta con un nombre propio, distinto del de los demás. Por eso, en tu robots.txt no puedes escribir una petición solo para él.
Cuatro diarios de Estados Unidos demandaron a Brave el 2 de noviembre, y tres de ellos le reprochan precisamente eso. Te contamos qué dicen las demandas, qué explica la propia Brave en su página de ayuda y qué puedes hacer en tu web.
Qué dicen las demandas
El 2 de noviembre, The New York Times demandó a Brave Software, la empresa del navegador, en un tribunal federal de Manhattan. Horas después, los editores del New York Daily News, el Chicago Tribune y el Orlando Sentinel presentaron otra demanda con acusaciones parecidas. Lo cuenta The Next Web, que ha leído el escrito de los tres diarios.
Las dos demandas se centran en el índice de Brave, la colección de más de 30.000 millones de páginas con la que funciona su buscador. Los diarios sostienen que Brave vende el acceso a ese índice a empresas de inteligencia artificial, a través de su API de búsqueda. La API es la puerta por la que otros programas consultan el buscador. Las dos demandas nombran a los mismos cinco clientes: Anthropic, Perplexity, Mistral, xAI y Cohere.
Según The Next Web, los diarios le reprochan además algo que toca a cualquier web: que nunca ha revelado el nombre de su rastreador. The Next Web explica por qué importa. Las webs pueden bloquear a los rastreadores por su nombre, y a uno cuyo nombre no se conoce no lo pueden identificar ni dejar fuera.
Son demandas, no sentencias. La pieza de The Next Web no recoge ninguna declaración de Brave.
Lo que dice Brave de su rastreador
Brave tiene una página de ayuda sobre su rastreador. Dice que no se presenta con un nombre propio para evitar que lo discriminen las webs que solo dejan entrar a Google. En ese punto, los diarios y la propia Brave describen lo mismo: no hay un nombre que escribir.
Esa misma página fija una regla. Si Googlebot no puede rastrear un dominio o una página, el rastreador de Brave tampoco lo rastrea.
Brave cuenta también para qué ofrece su índice. La página de su API dice que sirve para que las respuestas de una inteligencia artificial se apoyen en información actual, y que responde desde su propio índice. Añade que, con un plan que incluya derechos de almacenamiento, sus resultados se pueden guardar y usar para entrenar modelos.
Qué significa para tu web
Si no quieres que Brave rastree una página, no hay una línea con su nombre que escribir. Según Brave, lo que Googlebot no pueda rastrear tampoco lo rastrea el suyo, y el robots.txt es la forma habitual de cerrarle una página a Googlebot. Para decidir sobre Brave, lo que cuenta son tus reglas para Googlebot. El precio es que esa página tampoco la rastrea Googlebot: no puedes cerrársela a Brave sin cerrársela al rastreador de Google.
El 3 de noviembre contamos una regla común del robots.txt para pedir que no entrenen la IA con tu contenido. Google tiene además Google-Extended, su control para el entrenamiento de su IA. La página de Brave no nombra ninguna de las dos: la única regla de rastreo que da es la de Googlebot.
Que una página no salga en el buscador de Brave es otra cosa. Rastrear es visitar la página, e indexarla es guardarla para mostrarla en los resultados. Brave dice que el robots.txt no sirve para impedir que una página entre en su índice. Para sacarla, dice que se puede usar la etiqueta noindex, una línea en el código de la página que pide a los buscadores que no la muestren. Después, su rastreador tiene que volver a visitarla para aplicar el cambio, y Brave ofrece una página para pedirlo.
Google usa la misma etiqueta para quitar una página de sus resultados, y su documentación avisa de un cruce. Si el robots.txt le cierra la página, Googlebot nunca llega a leer la etiqueta noindex, y la página puede seguir saliendo en los resultados.
Qué puedes hacer ahora
- Mira qué dice hoy el robots.txt de tu web. Se ve escribiendo en el navegador la dirección de tu web seguida de /robots.txt. Fíjate en las reglas que afectan a Googlebot: las que lo nombran y las que empiezan por «User-agent: *», que van para todos. Según Brave, son también las que sigue su rastreador.
- No busques una línea con el nombre de Brave. Según los diarios y según la propia Brave, no hay nombre que escribir.
- Si una página no debe salir en los buscadores, usa noindex y no la cierres en el robots.txt. Si la cierras, el rastreador no llega a leer la etiqueta.
- Lo que no deba ver nadie no va en una página pública. El robots.txt es una petición, no un candado: lo que tiene que quedar privado va detrás de una contraseña.
Nuestro gestor de contenidos deja editar el robots.txt desde su sección Varios. Si estás pensando en una web nueva, cuéntanos qué necesitas y te preparamos una propuesta hecha para ti.
Fuentes
- Ana-Maria Stanciuc, «New York Times and three other US papers sue Brave over AI scraping», The Next Web, 2 de noviembre de 2026: https://thenextweb.com/news/nyt-newspapers-sue-brave-ai-scraping
- Brave, «Brave Search Crawler», ayuda de Brave Search, sin fecha en la página, consultada el 7 de noviembre de 2026: https://search.brave.com/help/brave-search-crawler
- Brave, «Brave Search API», consultada el 7 de noviembre de 2026: https://brave.com/search/api/
- Google Search Central, «Block Search indexing with noindex», versión en inglés, actualizada el 10 de diciembre de 2025: https://developers.google.com/search/docs/crawling-indexing/block-indexing
- Natalia Polo, «The New York Times y tres diarios más demandan a Brave por alimentar a la IA con su periodismo», WWWhat's new, 6 de noviembre de 2026: https://wwwhatsnew.com/2026/11/06/nyt-diarios-demandan-brave-ia-periodismo/